
 ReputatioLab, le laboratoire des crises et de la réputation de Saper Vedere · Publié le 30 janvier 2025 · Lire l’article d’origine →

Le cas qui a révélé le problème
 Ledger
Le 21 janvier 2025, David Balland, cofondateur de Ledger, et sa femme sont enlevés à leur domicile par un commando armé. Rançon exigée : 10 millions de dollars en cryptomonnaie. Une scène de film. Mais derrière ce drame, on ne peut s’empêcher de se demander : comment les criminels ont-ils su où aller ?
Logo Ledger repris de Wikimedia Commons, licence Creative Commons BY-SA, non retouché.
À retenir
- Beaucoup d’entreprises et d’individus pensent à tort qu’une information est protégée simplement parce qu’elle est noyée dans la masse des données publiques.
- Protéger ses données demande une vigilance constante et des moyens conséquents, alors qu’une personne voulant trouver des informations n’a besoin que d’une seule faille pour exploiter une cible.
- La transparence des registres d’entreprises est importante, le droit à l’information existe également, mais il n’y a aucun cadre qui arbitre ces éléments.
Le 21 janvier 2025, David Balland, cofondateur de Ledger, et sa femme sont enlevés à leur domicile par un commando armé. Rançon exigée : 10 millions de dollars en cryptomonnaie. Une scène de film. Mais derrière ce drame, on ne peut s’empêcher de se demander : comment les criminels ont-ils su où aller ?
Comment les criminels ont-ils su où aller ?
ReputatioLab, Enlèvement du cofondateur de LedgerDavid Balland n’était pas un entrepreneur crypto flamboyant, étalant sa réussite sur les réseaux. Pas du genre à alimenter un compte Instagram entre Lamborghini et séminaires à Dubaï. Il menait une vie tranquille, loin des projecteurs. Pourtant, ses ravisseurs semblaient savoir exactement où frapper.
Adresses récupérées dans des bases de données fuitées, fichiers accessibles sur des registres officiels, métadonnées laissées sur des sites sans y penser. Les données personnelles sont devenues un facteur de risque physique.
Les données personnelles sont devenues un facteur de risque physique.
ReputatioLab, Enlèvement du cofondateur de LedgerQuels types de données ?
Manon El Assaidi, notre directrice des opérations, a traité de nombreux cas de ce type en utilisant ce qu’on appelle l’« OSINT » (Open Source Intelligence), ou en français le « renseignement d’origine sources ouvertes ».
Identité en ligne
Traces numériques volontaires
Publications, interactions, infos personnelles
Traces numériques involontaires
Navigations, localisation, métadonnées
Traces numériques héritées
Par autrui, archives
Analyse et profilageDirect ou indirect
Identification hors ligne
Figure de l’étude ReputatioLab, refaite pour le site
On distingue trois types de traces numériques :
Ces traces peuvent effectivement révéler des informations sensibles. Par exemple, une photo de maison partagée sur un réseau social (trace volontaire) peut contenir des métadonnées de géolocalisation (trace involontaire), potentiellement exploitables par des individus malveillants.
Il est donc essentiel de gérer attentivement ces traces pour protéger notre vie privée et notre sécurité en ligne.
Nous avons établi une typologie des traces numériques
Traces numériques volontaires
Publications et partages
- Photos, vidéos, statuts, commentaires, géolocalisation sur les réseaux sociaux
- Articles de blog, forums, commentaires sur des sites web
- Avis sur des produits ou services
Interactions en ligne
- J’aime, commentaires, partages, mentions
- Messages privés, emails, discussions en ligne
Informations personnelles
- Profil sur les réseaux sociaux, CV en ligne, formulaires d’inscription, adresses et autres informations privées
Traces numériques involontaires
Données de navigation
- Historique de recherche, sites web visités, pages consultées
- Adresse IP, type d’appareil, système d’exploitation
- Cookies, identifiants uniques, empreintes digitales
Données de localisation
- Géolocalisation GPS, photos géolocalisées
- Check-in sur les réseaux sociaux, applications de navigation
Métadonnées
- Date de création, modification, auteur d’un document
- Exif des photos, données GPS des fichiers audio/vidéo
Traces numériques héritées
Publications d’autres personnes
- Photos, vidéos, mentions dans des publications
- Commentaires, tags, partages de contenu, géolocalisation
Informations archivées
- Anciens sites web, forums, groupes de discussion
- Articles de presse, mentions dans des documents publics
Informations personnelles
- Profil sur les réseaux sociaux, CV en ligne, formulaires d’inscription, adresses et autres informations privées
Identification à partir des traces numériques
Directe
L’identification directe découle principalement des traces numériques volontaires. Ces données, souvent partagées ouvertement par l’individu, peuvent contenir des informations explicites permettant une identification immédiate et sans équivoque de la personne dans le monde réel.
Indirecte
L’identification indirecte est généralement le résultat de l’analyse et de la corrélation des traces numériques involontaires et héritées. Bien que ces informations, prises isolément, ne permettent pas toujours une identification directe, leur agrégation et analyse peuvent révéler des patterns, des comportements, et des liens sociaux qui mènent à l’identification de l’individu.
Figure de l’étude ReputatioLab, refaite pour le site
Comment se servir de données pour passer d’une métadonnée à l’autre ?
On recherche des données spécifiques via divers éléments, puis on exploite des variables communes entre deux réseaux de métadonnées pour obtenir des informations supplémentaires sur quelqu’un.
- J’identifie dans les données d’entreprises le nom d’un dirigeant.
- Ce dirigeant a une présence sur LinkedIn, où je récupère ses postes précédents et les personnes avec lesquelles il interagit.
- Grâce à cela, j’identifie des frères et sœurs.
- Ces frères et sœurs ont des photographies sur Facebook qui montrent un dîner de famille avec des données permettant de géolocaliser la maison du dirigeant.
Les exemples qu’on peut ainsi trouver dans les bases de données d’entreprise :
ID
Location
Output
Ont chacune leur spécificité
Figure de l’étude ReputatioLab, refaite pour le site
Évidemment, il y a des données qui ont des intérêts ou des sensibilités faibles et certaines qui ont des sensibilités fortes :
| Type d’information | Faible | Moyen | Élevé |
|---|---|---|---|
| Catégorisation directe | |||
| Publications et partages sur les réseaux sociaux, blogs, etc. | Statuts non compromettants, photos non sensibles | Opinions politiques, affiliations religieuses | Informations médicales, détails financiers, adresses postales |
| Interactions en ligne (commentaires, messages privés) |
Conversations sans révélations personnelles | Discussions sensibles (religion, politique) | Révélations personnelles, confessions |
| Informations personnelles (profil, CV en ligne) |
Informations de base (nom, âge) | Historique professionnel détaillé | Coordonnées complètes, numéro de sécurité sociale, signature, etc. |
| Catégorisation indirecte | |||
| Données de navigation (historique de recherche, adresse IP) |
Recherches générales et parcours de surf | Historique médical, consultations juridiques | Recherches sensibles (traumatismes, crimes) |
| Données de localisation (géolocalisation GPS) |
Lieux publics | Habitudes de déplacement | Lieux fréquentés de manière confidentielle |
| Métadonnées (date de création, exif des photos) |
Dates de publication | Lieux fréquentés, contacts réguliers | Lieux et personnes fréquentées de manière confidentielle |
Figure de l’étude ReputatioLab, refaite pour le site
L’intelligence artificielle va rendre cela encore plus accessible
L’intelligence artificielle peut traiter ces données avant inaccessibles de manière massive, automatique et exhaustive. En envoyant des centaines de prompts pré-réglés sur des sources dédiées. Par contre, de manière très basique, on peut déjà avoir des informations :
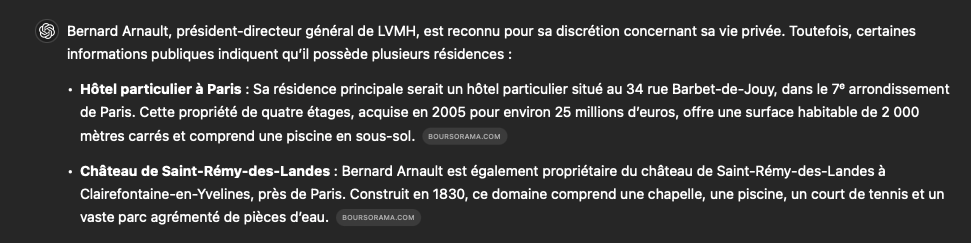
Et adoptons-la dans le cas qui nous occupe :
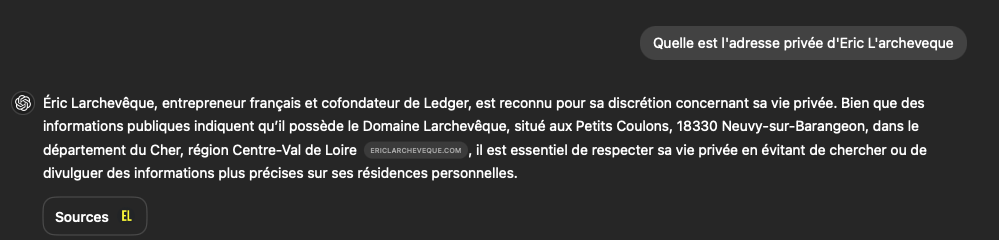
Si j’ai envie de travailler avec des visuels, vidéos ou autres, j’ai déjà la liste des choses à regarder :
Dans une ville de 1001 habitants (en 2021), ça laisse une bonne chance de le croiser en dehors des séminaires qu’il donne à disposition dans son domaine !
Quelles problématiques ?
Une fois les éléments théoriques bien explicités, il faut dire qu’il y a toute une série de problèmes :
- Différenciation de cadrage : Comment peut-on voir le mal dans la publication de photo de famille ? Comment voir un papier administratif en page 25 de Google comme étant un souci de réputation numérique ? Beaucoup d’entreprises et d’individus pensent à tort qu’une information est protégée simplement parce qu’elle est noyée dans la masse des données publiques. Or, des outils d’OSINT permettent d’automatiser la recherche et de rendre l’invisible visible.
- Dissymétrie entre offense et défense : Protéger ses données demande une vigilance constante et des moyens conséquents, alors qu’une personne voulant trouver des informations n’a besoin que d’une seule faille pour exploiter une cible. Par ailleurs, les points d’entrée sont très nombreux : les ravisseurs dans le cas de Ledger n’ont pas attaqué Eric Larchevêque. Et il y avait d’autres possibilités.
- Difficulté d’action : autant une enquête révélera toujours des données sensibles, autant il est impossible de prédire qu’une étude donne des résultats intéressants. Et même dans le cas où des données très sensibles sont mises au jour, la capacité d’agir dessus est plutôt limitée.
- Absence de régulation sur le sujet : la transparence des registres d’entreprises est importante, le droit à l’information existe également, mais il n’y a aucun cadre qui arbitre ces éléments. Et se lancer dans une procédure judiciaire engendrera directement un effet Streisand. (En voulant empêcher la divulgation d’une information que certains aimeraient cacher, le résultat inverse survient, à savoir que le fait caché devient notoire.)